Recherche d’images par le contenu
Comparaison de huit extracteurs de caractéristiques et trois mesures de distance pour retrouver des vêtements similaires, évaluée par MAP et MRR.
Problème
La recherche d’images par le contenu retrouve des images similaires à partir de leurs pixels, sans mots-clés ni légendes. Elle repose sur deux choix : comment transformer une image en vecteur, et comment comparer deux vecteurs. Je voulais mesurer quelle combinaison donne les résultats les plus pertinents sur un vrai catalogue, et à quel coût en temps de requête.
Approche
J’ai croisé huit extracteurs de caractéristiques avec trois mesures de distance, soit 24 combinaisons :
- des descripteurs locaux d’OpenCV, AKAZE et ORB. J’en ai fait un sac de mots visuels en apprenant un vocabulaire de 512 mots sur le catalogue, et chaque image devient un histogramme de taille fixe ;
- des réseaux pré-entraînés chargés avec timm, chacun avec son prétraitement : trois CNN issus d’ImageNet (VGG16, NASNetLarge, EfficientNetB7), un CNN récent et compact (ConvNeXt-Tiny), un vision transformer auto-supervisé (DINOv2) et un modèle image-texte (SigLIP 2) ;
- les distances cosinus, euclidienne et de Manhattan. La recherche est exhaustive et parcourt tout le catalogue : aucun index approché ne fausse les résultats.
Les données viennent du jeu Apparel Images de Kaggle : 11 385 images en 24 catégories, où chaque dossier indique une couleur et un style (par exemple « robe noire »). Un découpage stratifié et reproductible garde 7 627 images comme catalogue et 3 758 comme requêtes. Pour chaque requête, le système renvoie les 5 images les plus proches. J’ai noté les résultats sur la couleur, le style, puis les deux, avec la MAP@5, le MRR@5, la justesse au premier rang et le temps par requête.
Ce que j’ai construit
- Des extracteurs pour les deux descripteurs et les six réseaux, qui produisent tous des vecteurs de taille fixe, stockés dans un fichier Parquet par méthode.
- Une chaîne qui extrait le catalogue par lots et chaque requête une seule fois, puis lance les 24 recherches sur les vecteurs stockés, en chronométrant séparément l’extraction et la recherche. Un
Makefilela pilote, du téléchargement Kaggle à l’évaluation. - Les fonctions de métriques, avec des tests unitaires sur la normalisation de la précision moyenne, les requêtes sans vecteur et l’ordre des résultats pour chaque mesure.
Résultats
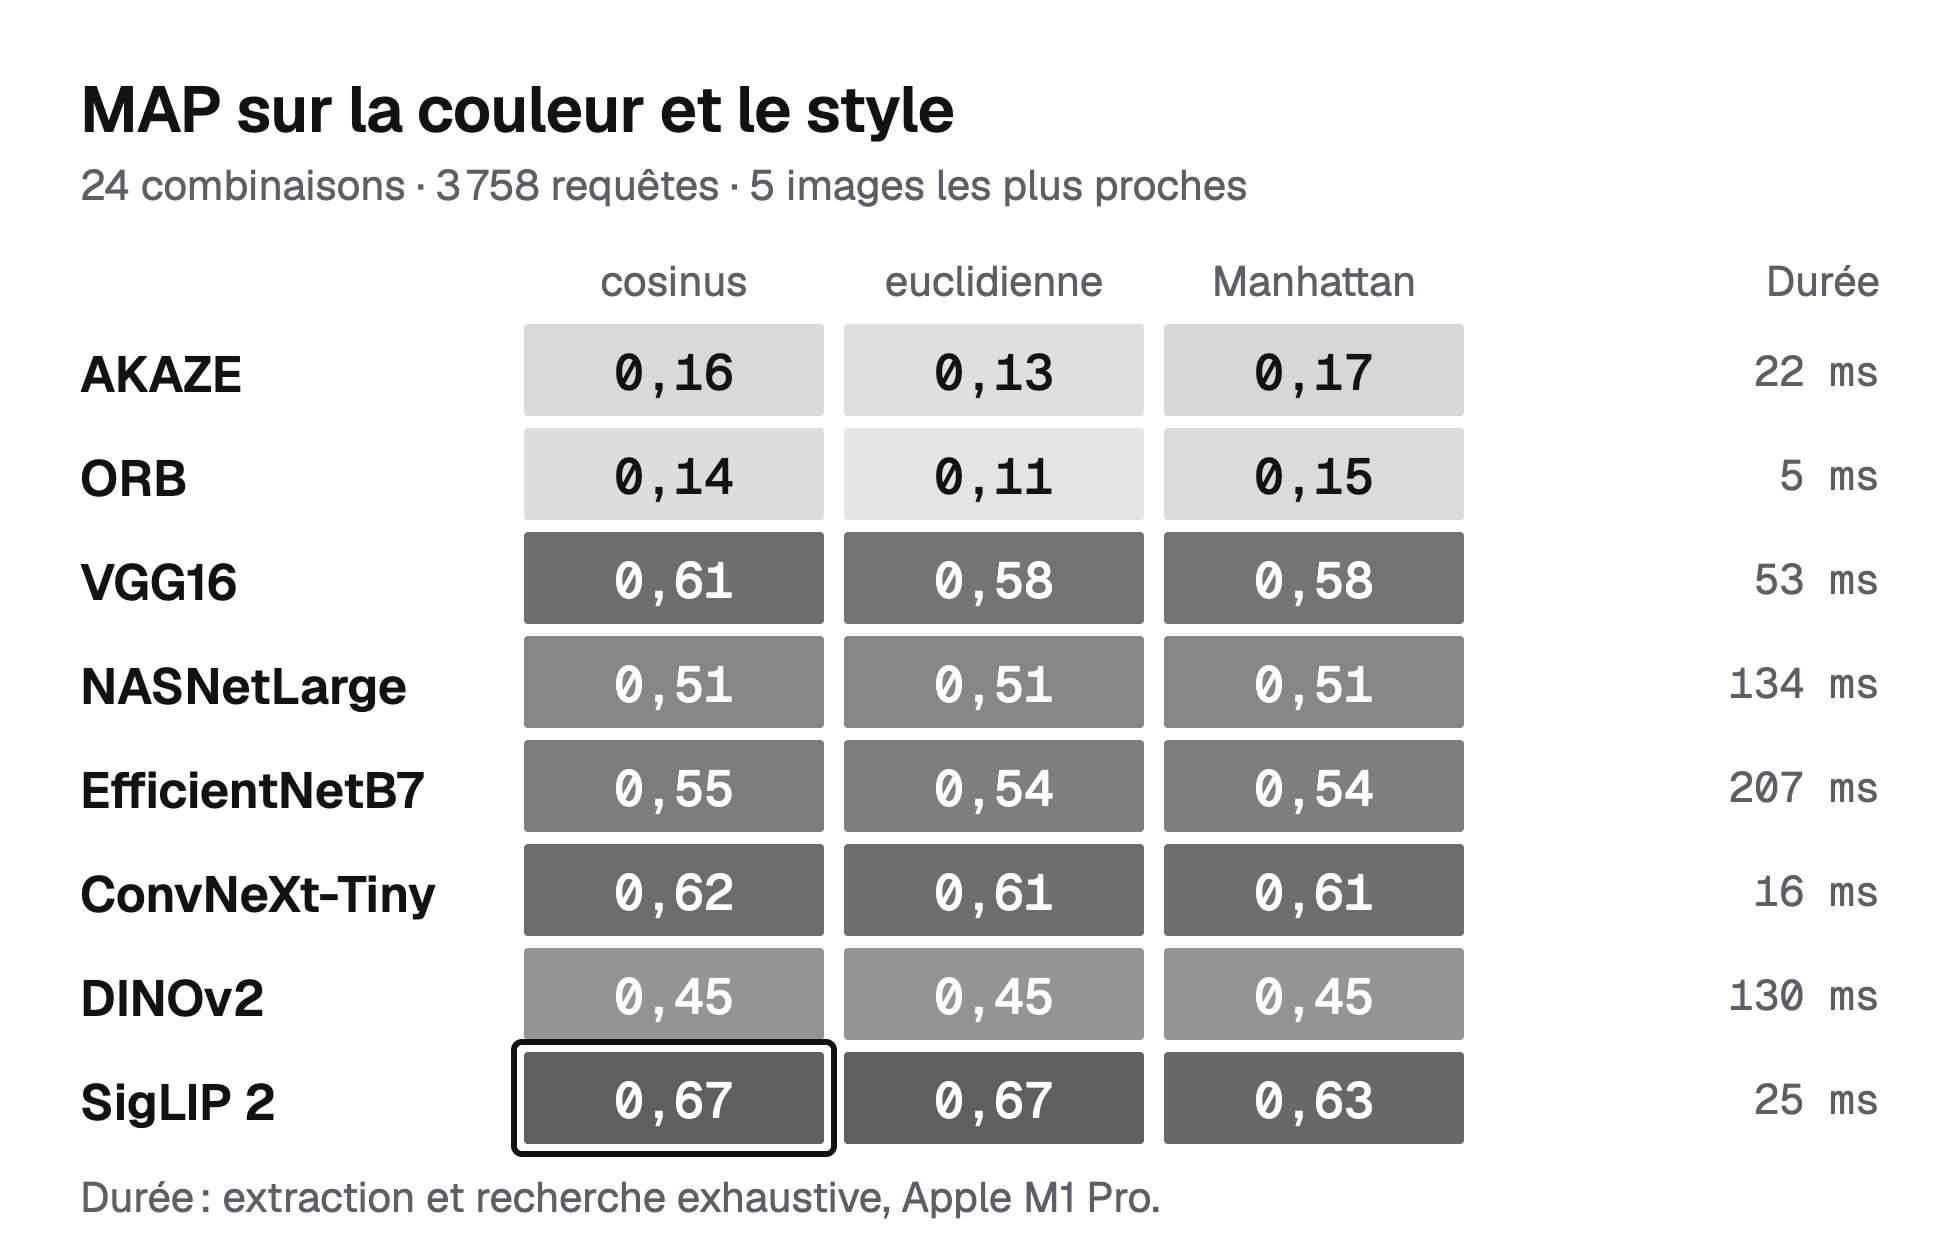
Les tableaux complets sont dans le notebook d’évaluation . Sur la tâche la plus difficile, retrouver la couleur et le style :
- SigLIP 2 avec la distance cosinus arrive en tête : MAP de 0,67, MRR de 0,87, justesse au premier rang de 0,80, en 25 ms par requête.
- ConvNeXt-Tiny est deuxième (MAP de 0,62) et le réseau le plus rapide, en 16 ms par requête.
- Les grands réseaux de la première version, EfficientNetB7 et NASNetLarge, sont moins précis (0,55 et 0,51) et 5 à 13 fois plus lents.
- Le meilleur descripteur local, AKAZE avec la distance de Manhattan, atteint une MAP de 0,17.
DINOv2 est le meilleur sur le style seul (MAP de 0,97) mais le plus faible des réseaux sur la couleur (0,46) : ses caractéristiques décrivent la forme plus que la couleur. Pour les réseaux, le choix de la mesure compte peu. Le temps de requête est presque entièrement de l’extraction : la recherche exhaustive sur 7 627 images prend moins de 1 ms en distance cosinus ou euclidienne.
Limites et pistes
J’ai d’abord mené cette étude en 2023 avec TensorFlow et cinq extracteurs. Ses résultats étaient faux, pour trois raisons. La recherche cosinus triait les similarités comme des distances, et renvoyait donc d’abord les images les moins similaires. Le calcul de la précision moyenne divisait par le nombre de bonnes réponses trouvées au lieu du nombre d’images pertinentes. Et les vecteurs des descripteurs contenaient les octets bruts des points clés, complétés par des zéros. J’ai corrigé les trois, migré vers PyTorch et timm, et tout relancé. Les chiffres ci-dessus remplacent ceux de 2023.
J’ai mesuré les temps sur un Apple M1 Pro, et ils dépendent du matériel. Un catalogue bien plus grand que 7 627 images demanderait un index de plus proches voisins approché. J’essaierais aussi d’affiner un modèle sur le catalogue plutôt que de garder des caractéristiques pré-entraînées figées.